 Max Korn
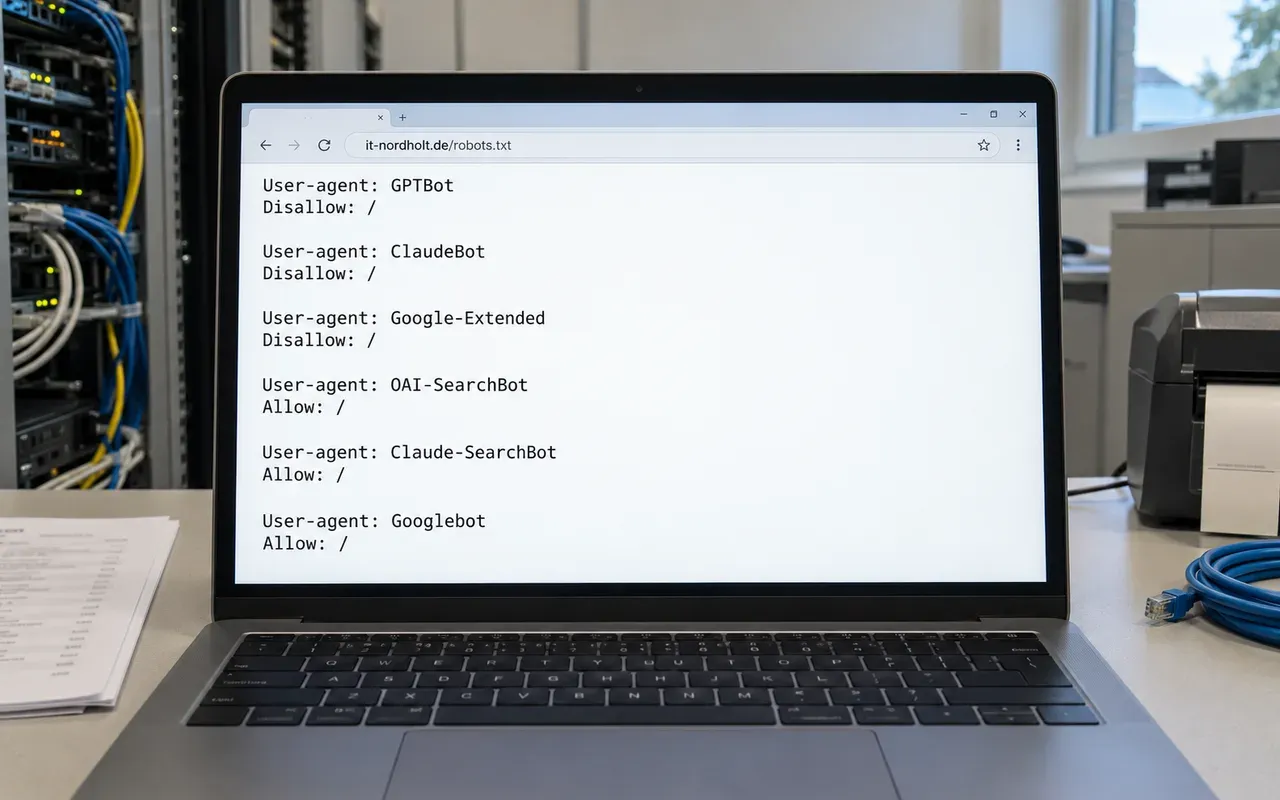
In deiner Server-Statistik tauchen Namen wie GPTBot oder ClaudeBot auf, und irgendwo hast du gelesen, dass man KI-Crawler blockieren sollte. Aber dann findet dich ChatGPT vielleicht nicht mehr, wenn jemand nach deiner Leistung fragt. Was sperrst du, und was lässt du lieber durch?
Bei den meisten Firmenwebsites bleiben Such- und Abruf-Bots sowie Googlebot erlaubt, denn deine Website soll gefunden werden. Trainings-Bots wie GPTBot, ClaudeBot oder Google-Extended kannst du sperren. Laut der Dokumentation von OpenAI, Anthropic und Google hängt die Sichtbarkeit in deren Suche an anderen Bots. Nötig ist eine Sperre vor allem dann, wenn deine Inhalte selbst das Produkt sind.
Training, Suche, Abruf: welcher Bot was macht
Hinter dem Wort „KI-Crawler“ stecken drei verschiedene Aufgaben. Trainings-Bots sammeln Inhalte, mit denen Sprachmodelle trainiert werden. Such-Bots bauen einen Index auf, aus dem eine KI-Suche Quellen anzeigt. Abruf-Bots holen eine Seite erst dann, wenn jemand im Chat konkret danach fragt.
In der robots.txt sprichst du jeden Bot über seinen Namen an, den sogenannten User-Agent.
| Zweck | OpenAI | Anthropic | Folge einer Sperre |
|---|---|---|---|
| Training | GPTBot |
ClaudeBot |
neue Inhalte werden nicht mehr fürs Training gesammelt |
| Suche | OAI-SearchBot |
Claude-SearchBot |
deine Seiten können in der ChatGPT-Suche fehlen und in Claude-Antworten seltener auftauchen |
| Abruf durch Nutzer | ChatGPT-User |
Claude-User |
laut Anthropic kann die Sichtbarkeit in Claude-Antworten sinken |
Die Namen stehen so im September 2026 in der Dokumentation der beiden Anbieter. Sie ändern sich gelegentlich. Schau deshalb vor einer Änderung kurz in die Originalquelle. Laut OpenAI sind die Einstellungen unabhängig voneinander: Du kannst OAI-SearchBot erlauben und GPTBot sperren.
Google fehlt in der Tabelle, weil es dort keinen eigenen KI-Crawler gibt.
Bei Google steuerst du Training und KI-Antworten getrennt
Googlebot ist der Crawler der Google-Suche. Für AI Overviews und AI Mode, also die KI-Antworten in der Google-Suche, nennt Google die robots.txt-Regeln für Googlebot als Steuerung. Einen separaten Such-Bot für KI gibt es nicht. Wer Googlebot wegen der KI-Antworten sperrt, sperrt ihn deshalb für die gesamte Google-Suche.
Google-Extended ist kein eigener Crawler, sondern ein Name, den du in der robots.txt einträgst. Gecrawlt wird weiter über die bekannten Google-Crawler. Der Eintrag regelt, ob Google deine Inhalte nutzen darf. Es geht um das Training künftiger Gemini-Modelle, um Gemini-Apps, die Vertex-AI-API und Grounding.
die Vertex-AI-API und Grounding. Grounding heißt, dass ein KI-Modell seine Antwort auf Inhalte aus dem Web stützt. in die Google-Suche und auf das Ranking hat Google-Extended laut Google keinen Einfluss.
Willst du nicht in AI Overviews erscheinen, hilft dir die robots.txt nicht weiter. Dafür gibt es einen Schalter in der Google Search Console. Unter Einstellungen → Search generative AI wählst du zwischen Include (Standard), Exclude und Inherit. Exclude hält deine Inhalte aus AI Overviews, AI Mode und den KI-Funktionen in Discover heraus.
Laut Google ist der Schalter seit dem 31. August 2026 für alle Websites weltweit verfügbar und kein Ranking-Signal für die übrige Suche. Er gilt für die ganze Website, wie sie in der Search Console eingerichtet ist, nicht für einzelne Seiten. Für das Training verweist Google auch hier auf Google-Extended.
Für einzelne Seiten oder Textstellen nennt Google zusätzlich die Anweisungen nosnippet, data-nosnippet, max-snippet und noindex, die im Seitencode gesetzt werden. Bevor du etwas abschaltest, lohnt es sich zu prüfen, ob deine Website in Googles KI-Antworten auftaucht.
Was die robots.txt kann und was nicht
Die robots.txt ist eine Textdatei, in der du Crawlern mitteilst, welche Bereiche sie auslesen dürfen. Laut dem Standard RFC 9309 sind diese Regeln keine Zugriffsberechtigung und kein Ersatz für echte Sicherheitsmaßnahmen. Google weist außerdem darauf hin, dass sich nicht alle Crawler daran halten.
Auch bei den großen Anbietern gibt es Unterschiede. Anthropic gibt an, die robots.txt zu beachten. Für ChatGPT-User gelten die Regeln laut OpenAI dagegen möglicherweise nicht.
Eine Sperre wirkt nur nach vorn. Was ein Crawler vorher eingesammelt hat, holt eine neue Zeile in der Datei nicht zurück.
Die Datei muss als /robots.txt im obersten Verzeichnis jedes Hosts liegen. Ein Shop unter shop.deinedomain.de braucht also eine eigene Datei. Crawler stattdessen per IP-Adresse auf dem Server auszusperren, nennt Anthropic unzuverlässig, weil der Crawler dann die robots.txt nicht mehr lesen kann.
Die robots.txt hält Seiten außerdem nicht aus Google heraus. Eine gesperrte URL kann laut Google trotzdem im Index landen, wenn andere Seiten auf sie verlinken.
Rechtlich spielt § 44b Abs. 3 UrhG eine Rolle. Ein Vorbehalt gegen Text- und Data-Mining, das automatisierte Auswerten von Inhalten, ist bei Online-Inhalten nur wirksam, wenn er maschinenlesbar erfolgt. Das Gesetz nennt die robots.txt dabei nicht ausdrücklich.
Ob die robots.txt im Einzelfall genügt, klärt eine Rechtsberatung.
Welche Einstellung für deine Firmenwebsite sinnvoll ist
Eine typische Firmenwebsite zeigt Leistungen, Referenzen und Kontaktwege. Sie soll gefunden werden, bei Google wie in KI-Suchen. Deshalb bleiben Googlebot, OAI-SearchBot, Claude-SearchBot und die beiden Abruf-Bots erlaubt. Solange keine Regel sie ausschließt, darfst du die Datei dafür so lassen, wie sie ist.
Bei den Trainings-Bots GPTBot, ClaudeBot und Google-Extended hast du die Wahl. Bei reinen Marketingtexten spricht wenig dagegen, sie zuzulassen. Eine Sperre ist genauso vertretbar.
Naheliegend wird die Sperre, wenn deine Inhalte selbst das Produkt sind: exklusive Fachartikel, ausführliche Leitfäden oder bezahlte Inhalte. Oder wenn du KI-Training mit deinen Inhalten schlicht nicht willst.
Zwei Dinge solltest du vermeiden. Kopierte Listen „aller KI-Bots“ aus dem Netz können auch Such-Bots enthalten und kosten dich dann Sichtbarkeit in ChatGPT oder Claude. Und Googlebot fasst du für KI-Zwecke gar nicht an. Für AI Overviews ist der Schalter in der Search Console der richtige Weg.
Denk an ein Brautmodengeschäft mit Leistungsseiten, Referenzfotos und Kontaktformular. Es will in seiner Region gefunden werden, auch wenn jemand ChatGPT nach Brautmode in der Nähe fragt. Seine Texte werben für sein Angebot, einen eigenen Wert als Produkt haben sie nicht. Es lässt alle Bots zu.
Ein zweiter, ebenfalls erfundener Fall: Ein Beratungsbüro für Fördermittel veröffentlicht ausführliche Leitfäden. Sie sollen seine Fachkenntnis zeigen und Anfragen bringen. Es sperrt GPTBot, ClaudeBot und Google-Extended. OAI-SearchBot, Claude-SearchBot und Googlebot lässt es zu.
So bleiben die Leitfäden in den Suchen auffindbar. Fürs Training werden sie nicht mehr gesammelt, soweit sich die Crawler an die Regeln halten.
So prüfst du deine robots.txt
Für diese Prüfung brauchst du nur einen Browser und ein paar Minuten:
- Ruf
deinedomain.de/robots.txtauf. Betreibst du Subdomains, etwa für einen Shop oder einen Blog, prüfst du jede einzeln. - Such nach einer pauschalen Sperre.
User-agent: *mitDisallow: /darunter schließt alle Crawler aus, die sich an die Datei halten, auch Googlebot. - Such nach Einträgen zu
GPTBot,OAI-SearchBot,ClaudeBot,Claude-SearchBotundGoogle-Extendedund vergleiche sie mit der Einstellung, die du willst. - Eine Sperre für einen einzelnen Bot besteht aus zwei Zeilen:
User-agent: GPTBotund darunterDisallow: /. - Klär, wer die Datei erzeugt. Sie kann vom CMS, einem SEO-Plugin oder dem Hoster stammen. Änderungen gehören dorthin, sonst überschreibt das System sie womöglich wieder.
Kannst du die Datei nicht selbst bearbeiten, gib deine Notizen an die Person, die deine Website betreut. Wenn du dabei Unterstützung brauchst, schaue ich mir deine robots.txt zusammen mit dir an.
